Domain alles-kein-problem.de kaufen?
Wir ziehen mit dem Projekt
alles-kein-problem.de um.
Sind Sie am Kauf der Domain
alles-kein-problem.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain alles-kein-problem.de kaufen?
Wie funktioniert die Textklassifizierung und welche Methoden werden dabei häufig angewendet?
Die Textklassifizierung ist ein maschinelles Lernverfahren, bei dem Texte automatisch in vordefinierte Kategorien eingeteilt werden. Häufig angewendete Methoden sind das Bag-of-Words-Modell, das TF-IDF-Verfahren und Machine-Learning-Algorithmen wie Naive Bayes oder Support Vector Machines. Diese Methoden analysieren den Text auf Basis von Merkmalen wie Wortfrequenzen oder semantischen Zusammenhängen, um eine präzise Klassifizierung zu ermöglichen. **
Was sind die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung?
Die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung sind die Verwendung von Machine Learning-Algorithmen wie Naive Bayes, Support Vector Machines und künstlichen neuronalen Netzen. Zudem werden häufig statistische Ansätze wie TF-IDF und Bag-of-Words verwendet, um Texte zu analysieren und zu kategorisieren. Auch die Verwendung von NLP-Techniken wie Named Entity Recognition und Sentiment Analysis kann bei der Kategorisierung von Texten hilfreich sein. **
Ähnliche Suchbegriffe für Textklassifizierung
Top-Angebote
Produkte zum Begriff Textklassifizierung:
-
Neuartige Technik zur Textklassifizierung, Taschenbuch von Abhishek Bhardwaj,Amarpreet Singh,Virat Rehani, Verlag Unser Wissen, 978-620-6-18723-3Neuartige Technik Zur Textklassifizierung, Taschenbuch Von Abhishek Bhardwaj,amarpreet Singh,virat Rehani, Verlag Unser Wissen, 978-620-6-18723-3, Seitenanzahl: 6843,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie kann Textklassifizierung dabei helfen, große Textmengen automatisch zu kategorisieren und analysieren?
Textklassifizierung kann dabei helfen, große Textmengen automatisch in vordefinierte Kategorien einzuteilen, um eine effiziente Analyse zu ermöglichen. Durch die automatische Kategorisierung können relevante Informationen schneller identifiziert und extrahiert werden. Dies ermöglicht eine schnellere Verarbeitung und Auswertung großer Textmengen. **
-
Was sind die gängigsten Techniken zur Textklassifizierung und welche Anwendungen können davon profitieren?
Die gängigsten Techniken zur Textklassifizierung sind Bag-of-Words, TF-IDF und Word Embeddings. Anwendungen wie Spam-Erkennung, Sentiment-Analyse und Themenmodellierung können von diesen Techniken profitieren. Durch die automatische Klassifizierung von Texten können Unternehmen effizienter arbeiten und bessere Entscheidungen treffen. **
-
Wie kann Textklassifizierung dabei helfen, große Mengen von Texten effizient zu analysieren und zu kategorisieren?
Textklassifizierung kann dabei helfen, große Mengen von Texten automatisch zu analysieren und in vordefinierte Kategorien einzuordnen. Dies spart Zeit und Ressourcen, da menschliche Eingriffe reduziert werden. Zudem ermöglicht es eine schnellere und präzisere Verarbeitung von Informationen. **
-
Wie kann Textklassifizierung dazu beitragen, große Mengen von Daten effizient zu organisieren und zu analysieren?
Textklassifizierung kann dabei helfen, Daten automatisch in verschiedene Kategorien einzuteilen, was die Organisation und Strukturierung erleichtert. Durch die automatische Zuordnung von Texten zu bestimmten Kategorien können relevante Informationen schneller gefunden und analysiert werden. Dies ermöglicht eine effiziente Verarbeitung großer Datenmengen und unterstützt somit die Entscheidungsfindung. **
Wie können maschinelle Lernalgorithmen zur Textklassifizierung effizient trainiert und eingesetzt werden, um semantische Kategorien zu erkennen?
Maschinelle Lernalgorithmen können effizient trainiert werden, indem sie mit einer großen Menge von annotierten Textdaten trainiert werden. Durch die Verwendung von Algorithmen wie dem Naive Bayes oder dem Support Vector Machine können semantische Kategorien erkannt werden. Um die Effizienz zu steigern, können auch Techniken wie Feature-Engineering und Hyperparameter-Optimierung eingesetzt werden. **
Was sind die gängigsten Methoden zur Textklassifizierung und wie können sie in der Praxis angewendet werden?
Die gängigsten Methoden zur Textklassifizierung sind Naive Bayes, Support Vector Machines und Neuronale Netze. Sie können in der Praxis verwendet werden, indem man Textdaten in Trainings- und Testdaten aufteilt, ein Modell mit den Trainingsdaten trainiert und dann die Genauigkeit des Modells mit den Testdaten überprüft. Die Methode mit der höchsten Genauigkeit wird dann für die Textklassifizierung verwendet. **
Top-Angebote
Produkte zum Begriff Textklassifizierung:
-
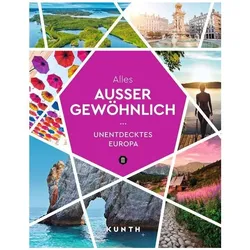
Alles, ausser gewöhnlich, Reisebücher von Kunth Verlag"Alles, ausser gewöhnlich" ist ein inspirierender Reisebildband, der Leser*innen zu aussergewöhnlichen und unentdeckten Reisezielen in Europa entführt. Abseits der üblichen Touristenströme bietet dieses Buch eine sorgfältige Auswahl von 53 einzigartigen Orten, die für jede Jahreszeit geeignet sind. Von romantischen Städten wie Évora in Portugal bis hin zu den kulturellen Highlights von Leeds in England und den einsamen Inseln des estnischen Archipels – die Vielfalt der vorgestellten Destinationen ist beeindruckend. Neben detaillierten Informationen zu Sehenswürdigkeiten, Hotels und Restaurants enthält der Band auch praktische Tipps für Ausflüge und besondere Erlebnisse, die den Aufenthalt unvergesslich machen. Dieses Buch ist ideal für alle, die neue Abenteuer abseits des Gewöhnlichen suchen und ihre Reiseplanung mit wertvollen Insider-Tipps bereichern möchten.29,95 €*Versand: 3,00 €Sichere Weiterleitung zum Anbieter
-
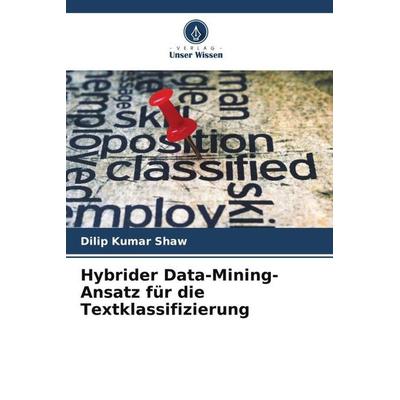
Hybrider Data-Mining-Ansatz für die Textklassifizierung, Taschenbuch von Dilip Kumar Shaw, Verlag Unser Wissen, 978-620-5-46330-7Hybrider Data-mining-ansatz Für Die Textklassifizierung, Taschenbuch Von Dilip Kumar Shaw, Verlag Unser Wissen, 978-620-5-46330-7, Seitenanzahl: 6835,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Neuartige Technik zur Textklassifizierung, Taschenbuch von Abhishek Bhardwaj,Amarpreet Singh,Virat Rehani, Verlag Unser Wissen, 978-620-6-18723-3Neuartige Technik Zur Textklassifizierung, Taschenbuch Von Abhishek Bhardwaj,amarpreet Singh,virat Rehani, Verlag Unser Wissen, 978-620-6-18723-3, Seitenanzahl: 6843,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert die Textklassifizierung und welche Methoden werden dabei häufig angewendet?
Die Textklassifizierung ist ein maschinelles Lernverfahren, bei dem Texte automatisch in vordefinierte Kategorien eingeteilt werden. Häufig angewendete Methoden sind das Bag-of-Words-Modell, das TF-IDF-Verfahren und Machine-Learning-Algorithmen wie Naive Bayes oder Support Vector Machines. Diese Methoden analysieren den Text auf Basis von Merkmalen wie Wortfrequenzen oder semantischen Zusammenhängen, um eine präzise Klassifizierung zu ermöglichen. **
-
Was sind die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung?
Die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung sind die Verwendung von Machine Learning-Algorithmen wie Naive Bayes, Support Vector Machines und künstlichen neuronalen Netzen. Zudem werden häufig statistische Ansätze wie TF-IDF und Bag-of-Words verwendet, um Texte zu analysieren und zu kategorisieren. Auch die Verwendung von NLP-Techniken wie Named Entity Recognition und Sentiment Analysis kann bei der Kategorisierung von Texten hilfreich sein. **
-
Wie kann Textklassifizierung dabei helfen, große Textmengen automatisch zu kategorisieren und analysieren?
Textklassifizierung kann dabei helfen, große Textmengen automatisch in vordefinierte Kategorien einzuteilen, um eine effiziente Analyse zu ermöglichen. Durch die automatische Kategorisierung können relevante Informationen schneller identifiziert und extrahiert werden. Dies ermöglicht eine schnellere Verarbeitung und Auswertung großer Textmengen. **
-
Was sind die gängigsten Techniken zur Textklassifizierung und welche Anwendungen können davon profitieren?
Die gängigsten Techniken zur Textklassifizierung sind Bag-of-Words, TF-IDF und Word Embeddings. Anwendungen wie Spam-Erkennung, Sentiment-Analyse und Themenmodellierung können von diesen Techniken profitieren. Durch die automatische Klassifizierung von Texten können Unternehmen effizienter arbeiten und bessere Entscheidungen treffen. **
Ähnliche Suchbegriffe für Textklassifizierung
-
Süße Welpenzeit - Alles außer gewöhnlich (Wandkalender 2027 DIN A2 quer), CALVENDO MonatskalenderDie Schönste Zeit Ist Die Welpenzeit. Ob Große Oder Kleine Rasse, Als Welpen Sind Sie Alle Süß Und Niedlich. Mit Zwölf Verschieden Rassehunde-babys Durch Das Jahr. Hochwertiger Wandkalender Mit 12 Wunderschönen Bildern. Weil Uns Unsere Umwelt Am...59,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann Textklassifizierung dabei helfen, große Mengen von Texten effizient zu analysieren und zu kategorisieren?
Textklassifizierung kann dabei helfen, große Mengen von Texten automatisch zu analysieren und in vordefinierte Kategorien einzuordnen. Dies spart Zeit und Ressourcen, da menschliche Eingriffe reduziert werden. Zudem ermöglicht es eine schnellere und präzisere Verarbeitung von Informationen. **
-
Wie kann Textklassifizierung dazu beitragen, große Mengen von Daten effizient zu organisieren und zu analysieren?
Textklassifizierung kann dabei helfen, Daten automatisch in verschiedene Kategorien einzuteilen, was die Organisation und Strukturierung erleichtert. Durch die automatische Zuordnung von Texten zu bestimmten Kategorien können relevante Informationen schneller gefunden und analysiert werden. Dies ermöglicht eine effiziente Verarbeitung großer Datenmengen und unterstützt somit die Entscheidungsfindung. **
-
Wie können maschinelle Lernalgorithmen zur Textklassifizierung effizient trainiert und eingesetzt werden, um semantische Kategorien zu erkennen?
Maschinelle Lernalgorithmen können effizient trainiert werden, indem sie mit einer großen Menge von annotierten Textdaten trainiert werden. Durch die Verwendung von Algorithmen wie dem Naive Bayes oder dem Support Vector Machine können semantische Kategorien erkannt werden. Um die Effizienz zu steigern, können auch Techniken wie Feature-Engineering und Hyperparameter-Optimierung eingesetzt werden. **
-
Was sind die gängigsten Methoden zur Textklassifizierung und wie können sie in der Praxis angewendet werden?
Die gängigsten Methoden zur Textklassifizierung sind Naive Bayes, Support Vector Machines und Neuronale Netze. Sie können in der Praxis verwendet werden, indem man Textdaten in Trainings- und Testdaten aufteilt, ein Modell mit den Trainingsdaten trainiert und dann die Genauigkeit des Modells mit den Testdaten überprüft. Die Methode mit der höchsten Genauigkeit wird dann für die Textklassifizierung verwendet. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.